我给自己建了一个数据库
2026-07-302020 年,我写过一篇《数字独立与自由》,谈的是个人在数字空间中应该享有哪些权利,以及我们可以怎样通过自己的认知、方法和工具去保障这些权利。在那之后我也尝试过做一些数据备份和收回(其实在那之前我已经开始做一些尝试),但是抓数据、处理数据这种体力活是非常耗费精力的,哪怕我具备编程能力。
六年后,在 AI 的帮助下,我终于将这个事情启动了起来,在一周左右的时间里,我把我的日记、工作日志、博客、微博、读书记录、游戏记录、观影记录、播客记录、Apple Health 数据、和 AI 的对话以及 LifeCycle/Rond 里的位置和活动记录,全部收集了起来然后放到了本地的一个 SQLite 数据库里。
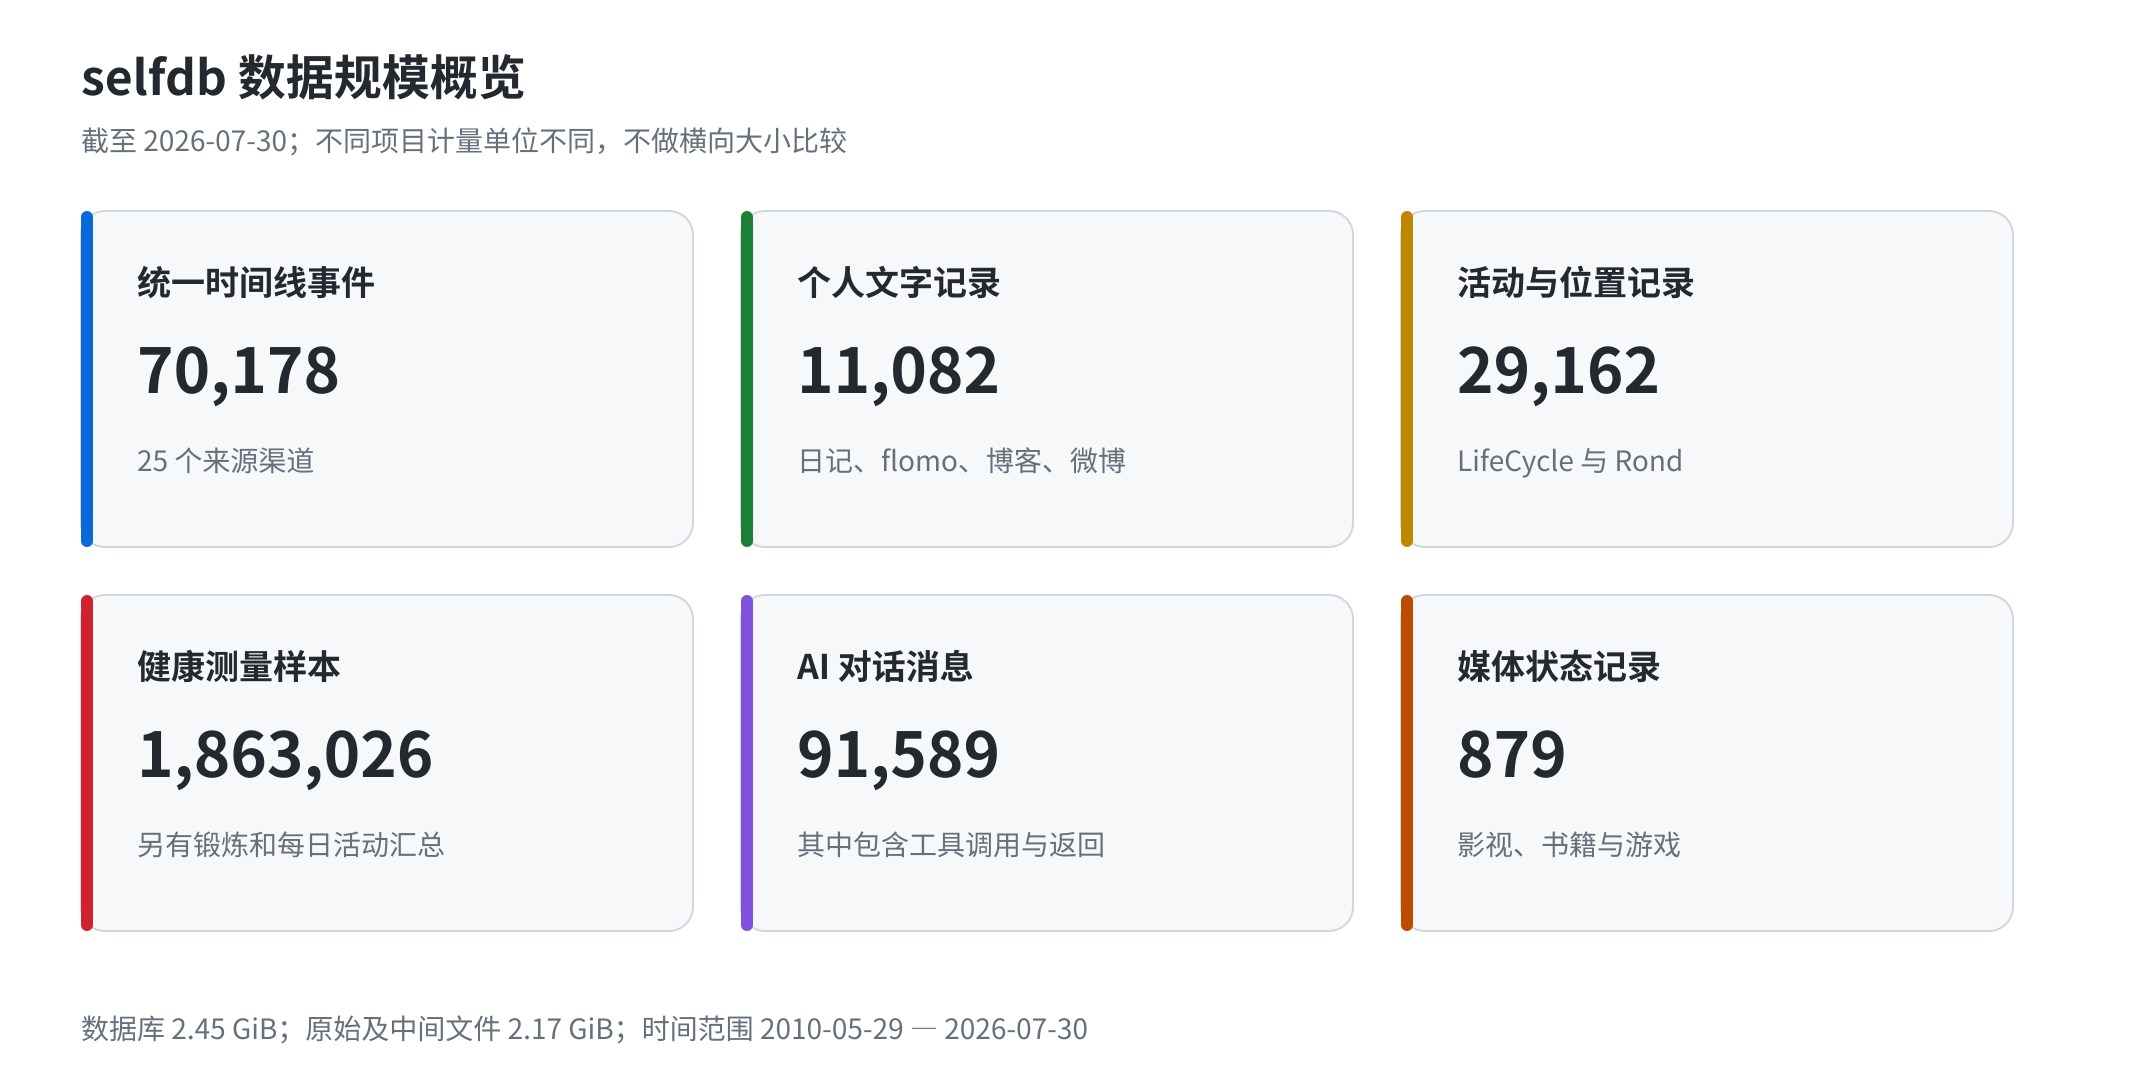
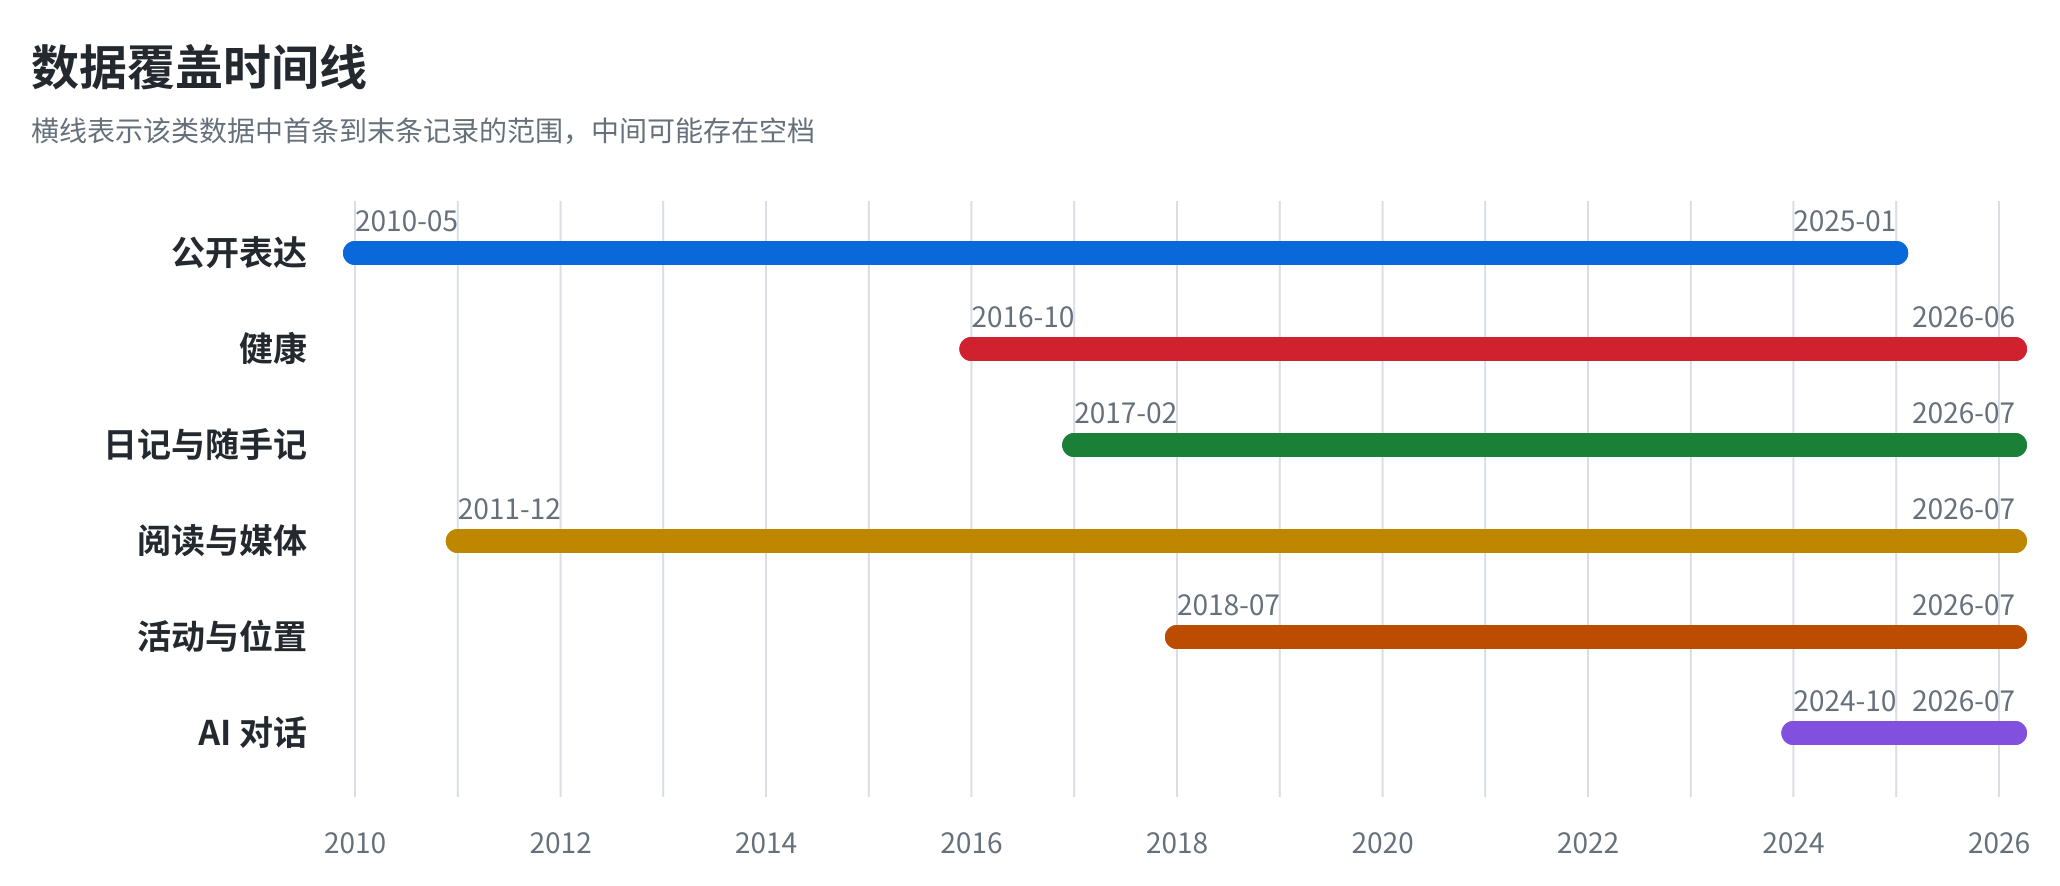
写这篇文章时,数据库里有 25 个来源渠道、70178 条统一时间线事件,覆盖 2010 年 5 月到 2026 年 7 月。其中有 11082 条日记、flomo、博客和微博记录,29162 条活动与位置记录,1863026 条 Apple Health 测量样本。十个 AI 工具合计有 1466 个会话、91589 条消息。
这些数字以后还会变化,所以图和正文里的统计都由一段脚本直接从数据库生成。数据库当前大约 2.46 GiB,保留的原始文件和中间文件大约 2.17 GiB。它不算小,但 SQLite 暂时处理得很好,而且使用单个文件保存和备份很方便。
把数据收回来
在我处理的这些数据里,有些是天然就容易解析的,比如说我的日记和工作日志,本来就是一堆纯文本文件。除此之外的各种平台、工具有些则提供了导出功能有些则没有,这里列一个表说下,如果读者有兴趣的话也可以去导出自己的数据:
| 数据渠道 | 导出支持情况 | 数据格式 | 获取方式 |
|---|---|---|---|
| flomo | 支持 | HTML | 设置 -> 导入导出 -> 导出笔记 |
| 豆瓣 | 不支持 | ||
| 微博 | 不支持 | ||
| 微信读书 | 部分支持 | JSON | API/Agent Skill |
| 哔哩哔哩 | 不支持 | ||
| 豆包 | 不支持 | ||
| DeepSeek | 支持 | JSON | 系统设置 -> 数据管理 -> 导出所有历史对话 |
| Gemini | 支持 | JSON | Google Takeout |
| ChatGPT | 支持 | JSON, HTML | Settings -> Data controls -> Export data |
| Claude | 支持 | JSON | Settings -> Privacy -> Export data |
| Apple Health | 支持 | ZIP(含 XML/CSV 等多种格式内容) | 手机上进 APP 点头像,下方“导出所有健康数据” |
能导出数据的平台或工具非常棒,但不支持的就麻烦了,以前还尝试过自己抓包写代码,但也很容易被反爬,现在就好了,直接让 AI 操作浏览器抓下来,行为也和一个真实用户差不多,完全没有问题。
拿到原始数据后,再就是进行处理然后入库,我现在是原始数据存一份,然后对各个渠道的数据写了导入器尽量统一格式再写入数据库。这么多个渠道,以前要是我自己写,怎么着也得十天半月的,现在有 AI 帮助,基本上利用下班后的业余时间也不过花了一周左右就基本搞好了。
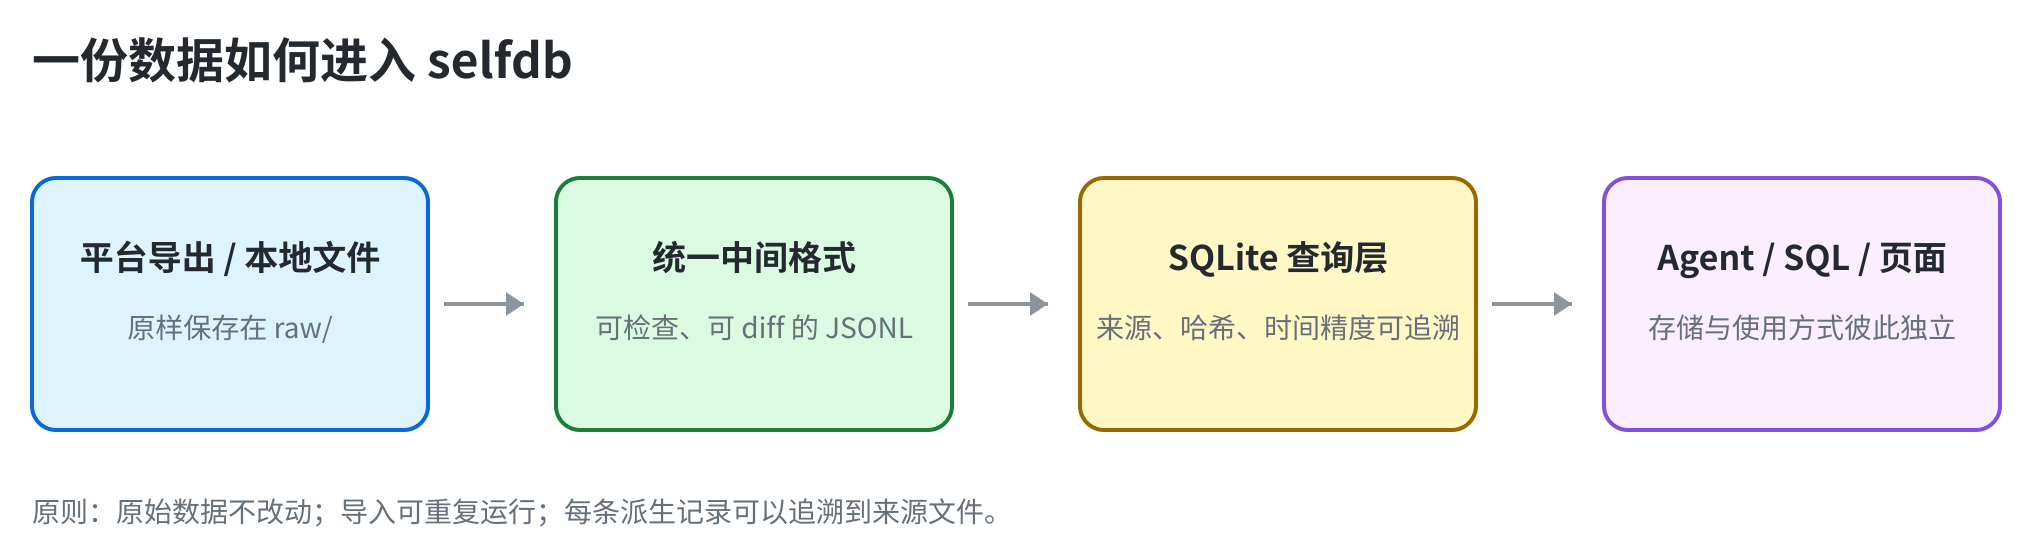
数据入库后可以配合一些可视化页面查询、展示,也可以直接让 AI 来读取使用,具体怎么用我在后面再说。
整个过程最麻烦的地方无疑还是第一步导出原始数据这里,后面的处理基本上让 AI 自己搞就行。所以以后选择软件和平台时,我会觉得他们能否便利、完整地导出数据,和他们的界面、功能、价格是同等重要的。
Agent 应该建立在谁的数据上
现在很多平台都在给自己的产品增加 agent。这当然有合理之处,如果 agent 深入到了平台的业务逻辑里,能替用户完成只有这个平台才能完成的操作,那么平台本身掌握的数据和能力就是优势。
但如果它提供的功能和业务逻辑并非不可替代的,我会更愿意把数据拿回来,交给自己选择的模型和 agent。平台里的 agent 通常只能看到平台内部的一小块数据,也很难理解一个人在其他地方做了什么。豆瓣知道我标记过哪些电影,却不知道我最近在听什么书;健康应用知道我几点睡觉,却不知道那一天是在旅行、加班还是玩游戏;笔记软件知道我写过什么,却不知道哪些想法后来真的变成了行动。
当数据在自己手里以后,模型、agent 和使用界面都可以替换。一个模型不合适,可以换另一个;一次分析的提示词不够好,可以重新写;某种交互方式不好用,也可以自己做一个页面。数据不需要跟着每一次工具变化重新迁移。
国内互联网环境让这件事显得更有必要。不同平台之间通常不会主动开放彼此的数据,完整的导出和稳定的 API 也不常见。每个平台都希望用户留在自己的边界里,然后在这个边界里提供一个声称了解用户的 agent。对平台来说这很自然,对我来说却未必是最好的安排。
我并不期待所有数据都必须公开流通。健康、位置、聊天和消费数据都很敏感,我希望它们首先由我控制,再由我决定在什么场景下让哪个工具读取哪些部分。数据可携带和保护隐私并不冲突;能够导出数据,也不等于必须把数据上传给另一家公司。
记录工具可能没那么重要了
我用过很多记录类工具:Org mode、flomo、日记应用、位置记录应用,以及各种带有统计功能的习惯工具。它们多少都有让我不满意的地方。有的输入很舒服但导出很差,有的数据很完整但浏览体验一般,有的统计图很好看却没办法挖掘细节之间的关联。
以前我会希望找到一个足够完美的工具,把记录、整理、统计和回顾全都做好。现在觉得这件事没有那么重要了。只要数据能够完整导出,一个工具可以只负责自己擅长的部分:笔记软件负责随手记录,健康应用负责采集,阅读器负责阅读,位置应用负责识别停留。统一、查询和长期保存由我自己的数据层完成。
这也降低了更换工具的成本。界面和功能仍然重要,因为它们决定每天愿不愿意使用;但一款工具不需要承担我全部的数字生活,也不应该通过扣住历史数据来强迫我一直使用。
数据可以拿来做什么
把数据收集起来后,最直接的用途当然是查询。例如某一天去了哪里、睡了多久、读了什么书、看了哪些视频、向 AI 提了多少个问题。这些查询大多不需要 AI,普通 SQL 就能准确完成,而这些 SQL(或者更进一步的查询界面) 则可以让 AI 帮我们提前写好。
Agent 更适合处理边界没那么清楚的问题。收集了各个渠道的数据后,我的第一个反应是让 AI 来梳理我的用户画像,得到的结果也还不错,不过限于个人隐私就不展示了。不过用户画像可能没什么用处,毕竟我对自己已经足够了解,我看总结的用户画像也和我对自己的认识没有太大的偏差,如果说要将这个用户画像用来指导 AI 怎么和我合作,似乎也没太大必要,毕竟我的日常还是以编程为主,在编程这个事情上,严格的代码规范和行为约束比所谓的用户画像要有用的多。
接着我尝试让 Agent 推荐一本我没读过的书、一款没玩过的游戏、一个没去过的地方和几部没看过的电影。
第一轮推荐,Agent 只是读了我的豆瓣、微信读书、Goodreads 上的记录然后进行推荐;第二轮,我要求 Agent 结合我其他的记录(日记、行动轨迹等)再次推荐;第三轮推荐,我要求推荐一些带给我新鲜感受的结果。这三轮推荐的结果如下表所示:
| 推荐轮次 | 领域 | 推荐名称 | 推荐逻辑 |
|---|---|---|---|
| 第一轮 | 书 | 《时间之子》 | 用非人类智能推演演化与文明发展,接续《盲视》与《群星》中的异质感 |
| 第一轮 | 游戏 | Lorelei and the Laser Eyes | 旧旅馆里的非线性硬核谜案,契合《动物井》式无明确指引的探索偏好 |
| 第一轮 | 地方 | 福建泉州 | 将对古建的偏好拓展至完整的城市历史,捞出曾经在笔记中提过的旅行念头 |
| 第二轮 | 书 | 《树上的男爵》 | 探讨怎样自主地活着,同时不离开世界,以奇怪但一致的约束,继续参与公共交往 |
| 第二轮 | 游戏 | 星际拓荒 (Outer Wilds) | 把“从痕迹中建立自己的理解”变成机制,契合你“跨领域系统考古者”的认知倾向 |
| 第二轮 | 地方 | 福建泉州 | 看宗教、贸易与普通生活如何层层叠加,满足系统考古倾向,而非单纯的景点打卡 |
| 第三轮 | 书 | 《夏日之书》 | 保留对日常细节的敏感,暂时拿掉宏大解释,体验既不温情脉脉、也不需要被解决的关系 |
| 第三轮 | 游戏 | Wandersong | 保留探索,拿掉阴郁气质与深层机制,尝试一种不设防的真诚、滑稽与乐观 |
| 第三轮 | 地方 | 黔东南 (肇兴/堂安) | 保留慢走观察,拿掉“看懂历史”的目的,短暂处在集体的声音和生活节律中 |
三轮推荐各有特色,但都非常对我的胃口。
作为对比,我去豆包、DeepSeek、Gemini、Deepseek 上又各自让他们做下推荐,结果如下:
| 平台 | 领域 | 推荐名称 | 推荐逻辑 |
|---|---|---|---|
| 豆包 | 书 | 《微光世界》 | 切中关注病痛缓慢侵蚀的体验,拿掉“寻找对策”,只描摹痛苦本身 |
| 豆包 | 游戏 | COCOON | 喜爱自成体系的内在运行规则,剥离文字与目标,纯靠直觉与空间探索 |
| 豆包 | 地方 | 茂兰原始森林 | 兴趣于实地系统观察自然结构,路况多变,无最优路线,打破预先规划 |
| DeepSeek | 书 | 《土星之环》 | 如同高度控制的系统遍历,拒绝论证闭环,承受联想中断 |
| DeepSeek | 游戏 | Before Your Eyes | 确定性的状态机与精确输入,强制放弃掌控时间线,体验错失 |
| DeepSeek | 地方 | 犬岛精炼所美术馆 | 废墟被精确转化为空间叙事系统,无操作说明,失去干预与反馈 |
| Gemini | 书 | 《索拉里斯星》 | 探索未知智能的底层机制,剥夺量化与优化视角,面对纯粹未知 |
| Gemini | 游戏 | 《极乐迪斯科》 | 技能树契合复杂系统调度偏好,移除最优解,强制体验失控与崩溃 |
| Gemini | 地方 | 丰岛美术馆 | 空间解耦与消除冗余的工程奇迹,抹去功能监控,切断解决问题的回路 |
| ChatGPT | 书 | A Philosophy of Walking | 散步观察自然,渴望规律而不规划,拿掉解题欲,将行走视为脱离目标的存续 |
| ChatGPT | 游戏 | Kentucky Route Zero | 偏好独立创作与信息架构,留下无法解释的空白,拒绝谜题 |
| ChatGPT | 地方 | Fogo Island | 关注人如何与环境技术共存,拿掉高密度刺激,允许不被完全理解 |
- 豆包推荐的游戏还可以但我玩过了,书就胡扯(可能因为我拿来多问了点身体方面的问题),茂兰原始森林还不错但我不可能千里迢迢跑过去就徒步的。
- DeepSeek 没有跨会话记忆功能,完全是基于我的提示词获得一个片面的对我的认识然后推荐的,忽略。
- Gemini 推荐的书还可以但是已经看过了,游戏的话玩过但没什么特别的感觉,丰岛美术馆在日本看了下毫无兴趣。
- ChatGPT 的三个推荐倒是意外的还可以,但也就是及格水平吧,没有惊喜。
除了推荐内容的话,还想到几个可能的用途:
- 从我的工作日志里提炼 SOP、工具偏好等;
- 提炼我长期关心的一些问题、主题(如人工智能、认知科学、投资等),然后做自动化的资料收集和追踪;
- 提炼我经常处理的问题、场景作为 FAQ,也就是作为个人知识库,当我再遇到类似问题的时候能直接查阅当时的回答、处理过程;
- 建立自己的行为预测模型,用来指导未来的行为(没有想很清楚,但有点大致思路)。